Já expliquei aqui o mecanismo central do branching do Lakebase: cópia instantânea, copy-on-write, sem duplicar dado até que algo de fato mude. Esse mecanismo é simples de entender em teoria. O que normalmente quebra na prática não é o branching em si, é tudo em volta dele, como manter o branch sincronizado com produção, quando apagar, e quem tem permissão pra acessar o quê. A Snorkel AI publicou os detalhes de como resolveu isso rodando até 100 bancos de pull request ativos ao mesmo tempo.
O problema de partida era concreto: cada pull request aberto ganhava seu próprio namespace Kubernetes isolado, mas restaurar uma cópia completa do banco de produção Aurora PostgreSQL (na casa do terabyte) levava cerca de 20 minutos por ambiente. Pra um time que abre e fecha pull request o dia inteiro, isso é tempo de espera que ninguém tolera, e normalmente vira desculpa pra testar contra um banco de teste genérico que não reflete produção de verdade.
O mecanismo: DMS alimentando o branch principal, não o teste direto
A peça que faz o resto funcionar não é o branching em si, é o que alimenta o branch principal (production) do projeto Lakebase. A Snorkel replica produção pro branch principal usando AWS DMS (Database Migration Service): carga completa inicial, seguida de captura de mudança contínua (CDC), mantendo o branch principal a cerca de 2 minutos de distância do estado real de produção.
Com o branch principal sempre fresco, cada pull request aberto dispara, via CI, a criação de um branch copy-on-write a partir dele, com um TTL (tempo de vida) definido. O CI passa os dados de conexão desse branch pro namespace Kubernetes daquele pull request, os testes rodam contra dado real e atual, e o branch é apagado quando o pull request fecha, com o TTL funcionando como rede de segurança caso alguém esqueça de fechar.
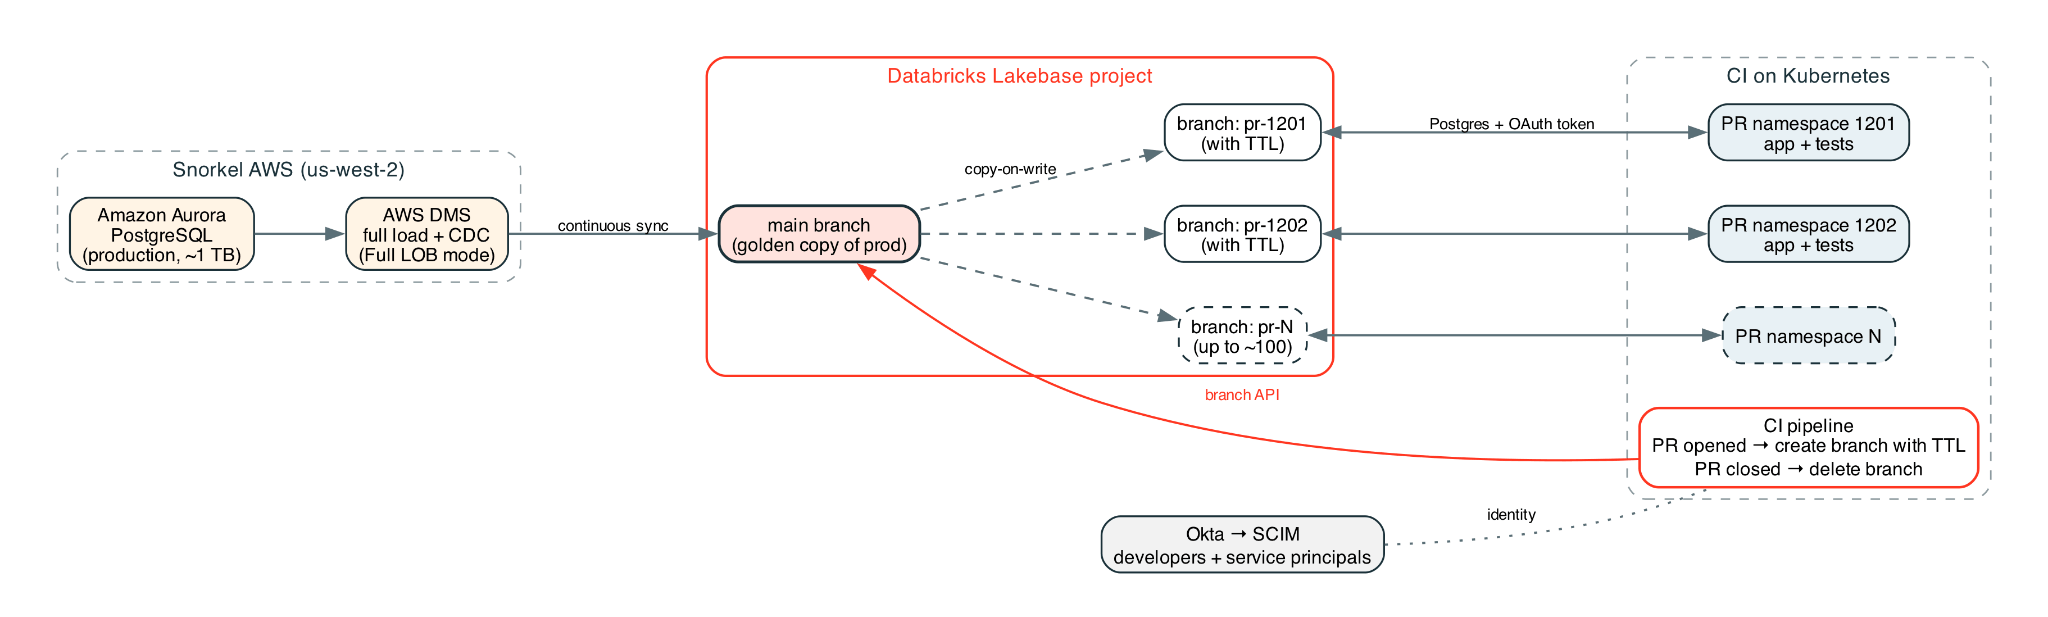
Arquitetura publicada pela Databricks: DMS replica produção continuamente pro branch principal, e cada pull request recebe seu próprio branch isolado, criado sob demanda.
Mão na massa: criando um branch com expiração real via CLI
O mecanismo de TTL que a Snorkel usa pra apagar branch de pull request automaticamente não é um script próprio, é um recurso nativo do Lakebase: expiração de branch, com modelo de time-to-live, teto de 30 dias a partir do momento da criação. A forma mais direta de criar isso no pipeline de CI é via CLI do Databricks, passando a expiração junto com a criação:
# Cria um branch de pull request a partir do branch principal,
# com expiração automática em 4 horas (14400 segundos),
# faixa recomendada pela própria documentação pra ambiente de CI/CD
databricks postgres create-branch projects/meu-projeto pr-4821 \
  --json '{
    "spec": {
      "source_branch": "projects/meu-projeto/branches/production",
      "ttl": "14400s"
    }
  }'
O mesmo via SDK Python, útil quando o passo de CI já está escrito em Python em vez de shell:
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.postgres import Branch, BranchSpec, Duration

w = WorkspaceClient()

branch_spec = BranchSpec(
    ttl=Duration(seconds=14400),  # 4 horas
    source_branch="projects/meu-projeto/branches/production",
)

resultado = w.postgres.create_branch(
    parent="projects/meu-projeto",
    branch=Branch(spec=branch_spec),
    branch_id="pr-4821",
).wait()

print(f"Branch criado: {resultado.name}")
print(f"Expira em: {resultado.status.expire_time}")
E a limpeza no fechamento do pull request, caso o CI consiga apagar explicitamente em vez de esperar o TTL expirar sozinho:
databricks postgres delete-branch projects/meu-projeto/branches/pr-4821
A documentação é explícita sobre uma regra que facilmente passa despercebida: branch protegido e branch default não podem ter expiração, e branch com filho não pode expirar (o filho precisa ser apagado primeiro). Isso significa que o padrão da Snorkel só funciona porque o branch de pull request é sempre folha da árvore, nunca pai de outro branch.
O detalhe que a maioria ignora: TTL não é só limpeza, é controle de custo de storage
Minha leitura: o ponto mais sutil do caso, e o que mais vale levar pra outro contexto, é que TTL curto não existe só pra não acumular branch esquecido, existe porque o modelo de cobrança do Lakebase trata branch expirável e branch permanente de formas diferentes. Um branch com expiração é cobrado só pelo dado que muda nele, via copy-on-write, compartilhando com o pai o que não mudou. Um branch permanente, sem expiração, é cobrado pelo tamanho total do dado, como se fosse um banco independente, mesmo que a diferença real pro pai seja mínima. Decidir “nunca expirar” numa branch de staging ou de desenvolvedor individual, sem pensar nisso, é decidir pagar pelo banco inteiro de novo.
Os números de dimensionamento da Snorkel dão a escala real do problema: cada branch de pull request adiciona entre 5 e 10 GB de mudança, e de 20 a 30 dos 100 branches provisionados ficam ativos no pico, cada um recebendo cerca de 5 consultas por segundo.
Identidade separada pra humano e pra pipeline
A segunda decisão de design que vale reter é a separação de modelo de identidade. Desenvolvedor humano entra via SSO (Okta, provisionado via SCIM). Pod de CI roda como service principal, usando token OAuth de curta duração obtido via SDK da Databricks, renovado durante execução de teste longa. O log de auditoria do Postgres registra qual service principal fez cada consulta, não um usuário genérico de serviço compartilhado.
Essa separação importa porque, sem ela, a tentação natural é usar uma única credencial de serviço de longa duração pra todo pipeline de CI, o que simplifica a configuração inicial mas cria exatamente o tipo de credencial permanente, de escopo amplo, que uma violação de segurança adora encontrar.
O que isso não resolve
O próprio material publicado tem uma lacuna de medição honesta: o percentil 95 de tempo de provisionamento aparece marcado como não verificado no texto original, só a melhora de “mais de 30 minutos” pra “menos de 60 segundos” é afirmada com confiança. Vale tratar o ganho de velocidade como real (a ordem de grandeza bate com o que o mecanismo de copy-on-write promete), mas não citar o p95 específico como se fosse validado.
Minha ressalva: o desenho inteiro depende de um pressuposto que nem toda empresa tem hoje, DMS já configurado e funcionando pra alimentar o branch principal continuamente. Pra quem ainda não tem pipeline de replicação de produção rodando, o investimento real não é no branching em si (isso é rápido de configurar, como o bloco de código acima mostra), é em montar e confiar nesse pipeline de replicação como fonte de verdade, e isso é um projeto de infraestrutura à parte, não um efeito colateral de ativar o Lakebase. Vale notar também o teto real de 30 dias de expiração: pra um branch que precisa viver mais que isso (ambiente de staging de longo prazo, por exemplo), a estratégia correta não é TTL automático, é renovação manual da expiração antes dela vencer, ou aceitar o custo de um branch permanente conscientemente.
Vale adotar?
Sim, especificamente pra quem já sofre com o ciclo lento de “restaurar banco de teste” a cada pull request, e já tem (ou está disposto a montar) uma esteira de replicação contínua de produção. O ganho de testar contra dado real, em vez de fixture sintética que sempre fica desatualizada em relação ao schema de produção, é o tipo de coisa que só fica óbvio depois que você experimenta, mas que explica por que o time trouxe o mesmo padrão pra planejar uso por agente de IA também, um branch por tarefa, revisão antes de aplicar, descarte ao final.
Referências
- Databricks Blog, “Lakebase branching for CI/CD: lessons from 100 PR databases”: https://www.databricks.com/blog/lakebase-branching-cicd-lessons-100-pr-databases
- Microsoft Learn, “Lakebase Postgres - Azure Databricks”: https://learn.microsoft.com/en-us/azure/databricks/oltp/projects/
- Microsoft Learn, “Branches - Azure Databricks”: https://learn.microsoft.com/en-us/azure/databricks/oltp/projects/branches
- Microsoft Learn, “Manage branches - Azure Databricks”: https://learn.microsoft.com/en-us/azure/databricks/oltp/projects/manage-branches
#AzureDatabricks #Lakebase #CICD #DevOps