Toda vez que um agente de IA esquece o que você disse duas conversas atrás, a reação mais comum é pedir uma janela de contexto maior. É a correção óbvia, e também a errada na maior parte dos casos: jogar histórico inteiro de volta pro prompt custa token, custa latência, e ainda assim não resolve o problema real, que é separar o que aconteceu do que importa reter.
Já falei aqui sobre o lançamento do Agent Memory em Beta no Azure Databricks. Esse foi o anúncio do produto. O que ficou de fora dessa cobertura foi o mecanismo de pesquisa por trás dele, e é justamente aí que mora a parte mais interessante: um desenho de duas camadas de memória, testado contra benchmark aberto e contra um benchmark interno construído a partir de sessão real do Genie, que triplicou taxa de sucesso em tarefa comparado a não ter memória nenhuma, usando uma fração do token que um contexto completo exigiria.
O problema: lembrar tudo não é a mesma coisa que lembrar o que importa
A forma mais simples de dar memória a um agente é guardar a conversa inteira e reinjetar ela no prompt da próxima sessão. Isso funciona até o histórico crescer: cada sessão nova fica mais cara, mais lenta, e o modelo ainda precisa separar o sinal relevante do ruído de conversa antiga toda vez que processa aquele contexto gigante.
O ponto de partida do mecanismo é tratar memória como duas coisas fundamentalmente diferentes, não uma: memória episódica, o registro bruto e append-only de cada sessão, tal como ela aconteceu; e memória derivada, o aprendizado já destilado, guardado como arquivo numa base de conhecimento organizada hierarquicamente, com um índice gerado automaticamente (memory.md) descrevendo a estrutura.
O mecanismo de três acessos: plugin, ferramenta e pipeline offline
A parte prática do desenho tem três jeitos diferentes do agente interagir com essa memória, cada um resolvendo uma necessidade diferente:
- Plugin: registra passo a passo da sessão automaticamente e injeta o índice de memória assim que a sessão começa, sem o agente precisar pedir nada
- Ferramentas do agente:
add_memory,update_memoryedelete_memorytratam pedido explícito do usuário (“lembre que eu prefiro resposta curta”), enquantosearch_memoryefetch_memoryfazem leitura sob demanda através dos dois tipos de memória - Pipeline offline de “sonhar” (dreaming): roda agendado ou disparado por evento, extrai aprendizado implícito que ninguém pediu explicitamente pra guardar, divide arquivo que cresceu demais, funde entrada duplicada e resolve conflito quando uma conversa mais nova contradiz uma mais antiga
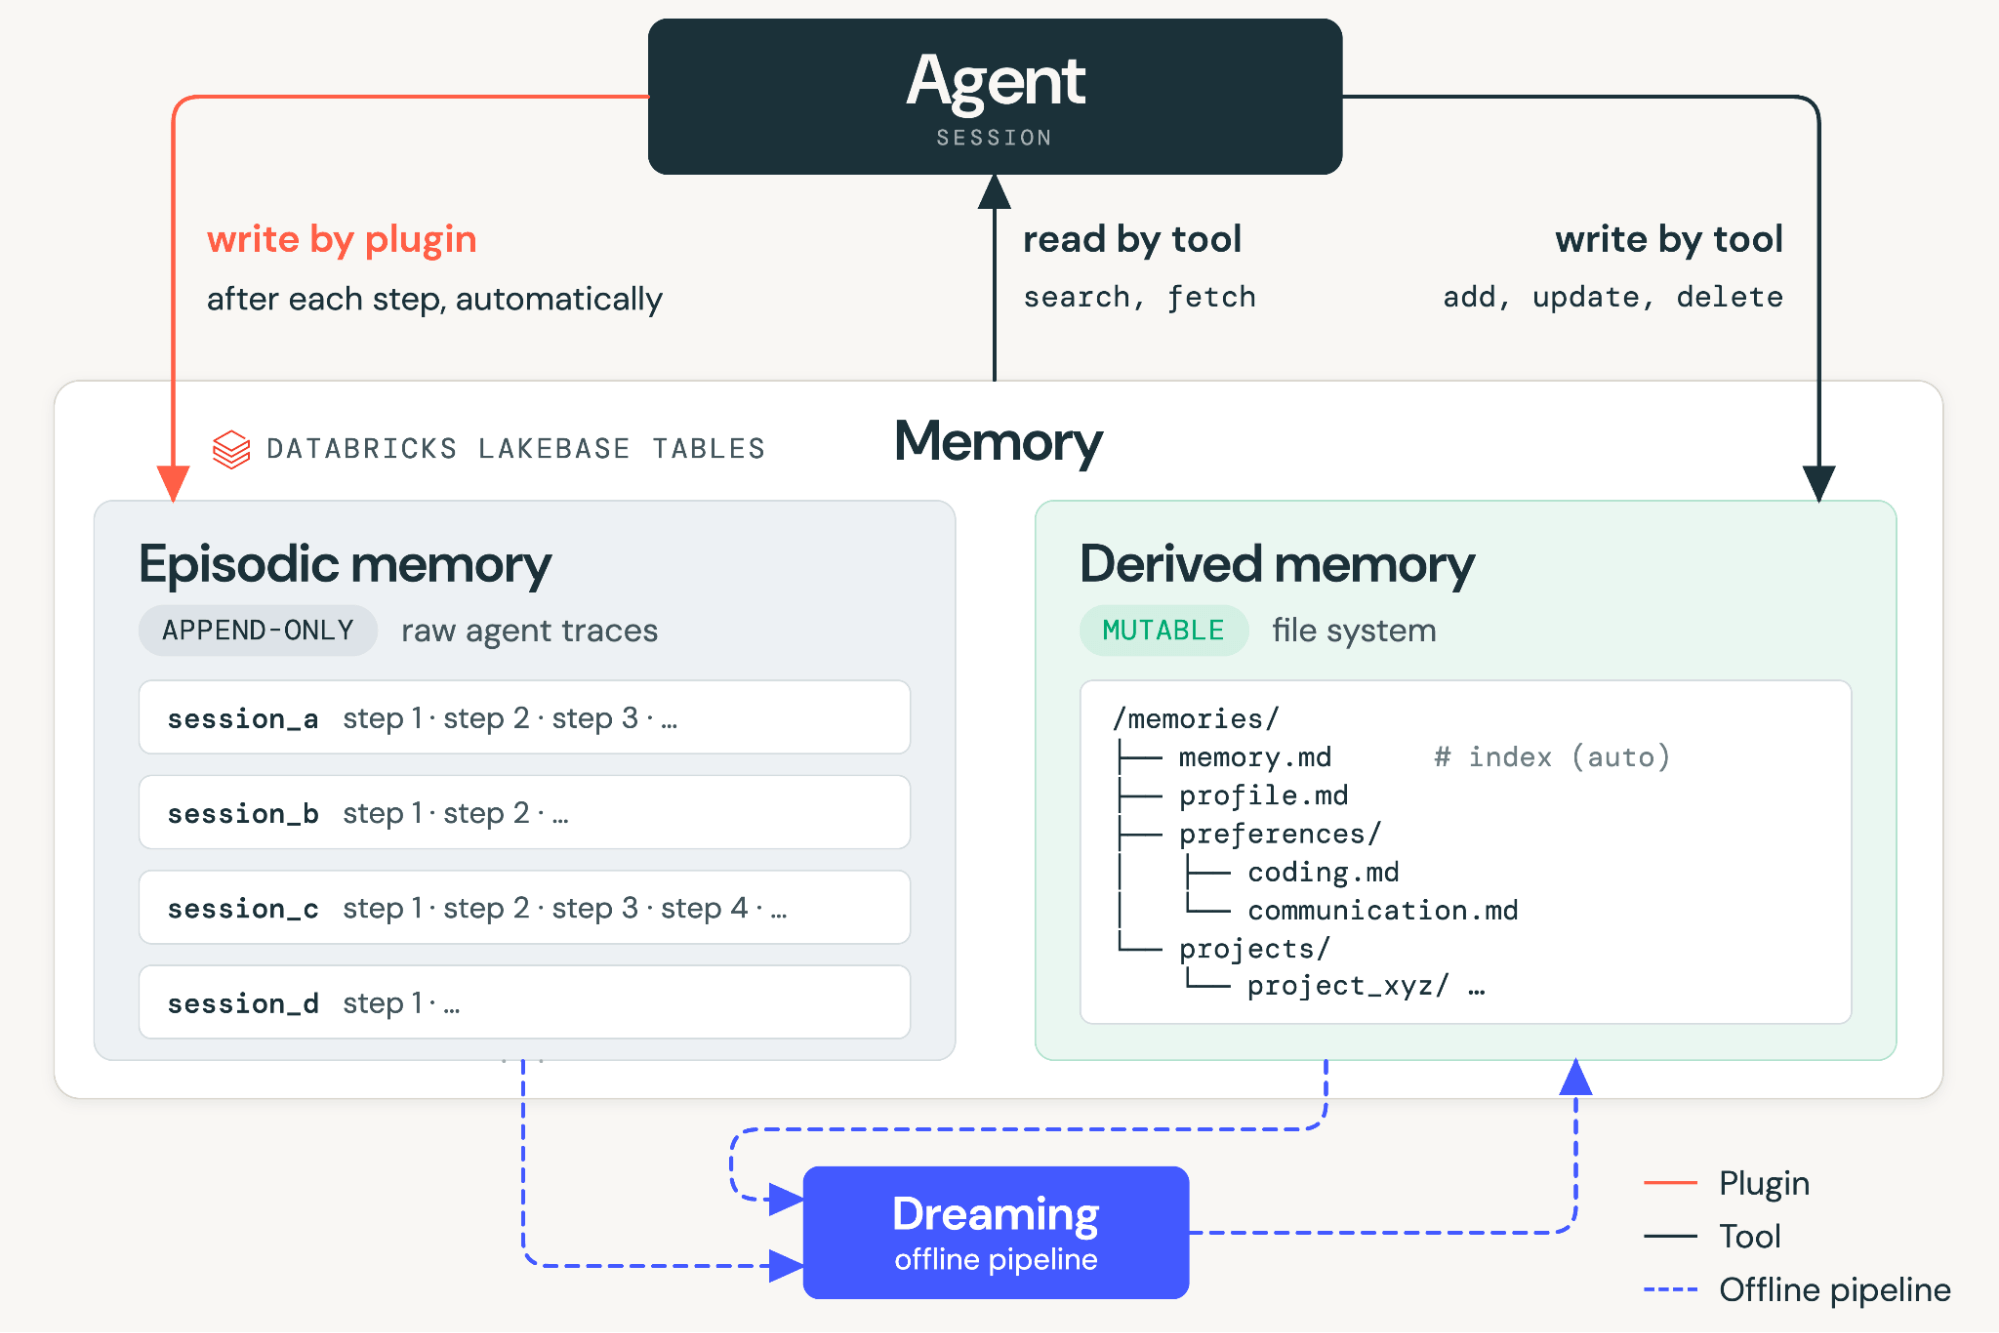
O mecanismo de duas camadas: registro bruto de cada sessão de um lado, conhecimento já destilado do outro, com um pipeline em segundo plano fazendo a ponte entre os dois sem depender do agente fazer isso no meio da tarefa.
Minha leitura: o detalhe mais relevante aqui não é ter dois tipos de memória, é onde a destilação acontece. Fazer o próprio agente resumir e decidir o que vale reter, no meio da tarefa, compete por atenção e token com o trabalho que ele já estava fazendo. Mover essa responsabilidade pra um processo offline, que roda depois, sem pressão de tempo real, é a escolha de engenharia que faz o resto do desenho funcionar.
O que a pesquisa mediu: dois benchmarks, não só um
A validação usou dois conjuntos de teste com propósitos diferentes. Primeiro, benchmarks abertos já estabelecidos na literatura (LoCoMo, LongMemEval, ConvoMem), onde o mecanismo de duas camadas chegou a 88,1% de acurácia, próximo do resultado de usar o contexto completo (87,8%), mas consumindo cerca de 8,4 mil tokens de entrada por pergunta contra 103 mil do contexto completo, uma diferença de aproximadamente 12 vezes.
Segundo, e mais revelador, um benchmark interno construído a partir de sessão real do Genie (114 casos de teste, 29 usuários, 2.233 sessões de histórico), medindo não só acurácia de resposta, mas taxa de sucesso de tarefa completa:
Taxa de sucesso de tarefa, benchmark interno (Genie):
  Sem memória nenhuma:         22,3%
  Mem0 (biblioteca de memória externa): 43,9%
  Mecanismo de duas camadas:   68,4%
  Injeção do histórico "ideal" (teto de referência): 78,6%
A comparação contra Mem0, uma biblioteca de memória de agente já conhecida na comunidade, importa porque não é só “memória versus nenhuma memória”, é “esse desenho específico versus outra forma já existente de resolver o mesmo problema”, e a diferença entre os dois (68,4% contra 43,9%) é grande o suficiente pra não ser ruído de medição.
Mão na massa: o que muda na prática pra quem constrói o agente
Do ponto de vista de quem implementa, o padrão se resume a decidir, pra cada fato que o agente aprende durante uma sessão, se ele pertence ao registro bruto ou se merece virar entrada na base destilada. Um esboço conceitual de como essa decisão poderia ficar explícita no código do agente, escrito a partir do mecanismo descrito, não copiado de nenhuma fonte:
# Esboço conceitual: decidir entre registro episódico (bruto)
# e memória derivada (destilada), separando o que aconteceu
# do que vale reter entre sessões.

def processar_evento_de_sessao(evento, memoria_derivada):
    # Memória episódica: sempre grava, append-only, sem julgamento
    registrar_evento_bruto(evento)

    # Só promove pra memória derivada o que parece durável:
    # preferência explícita, decisão de negócio, correção de erro
    if evento.tipo in ("preferencia_explicita", "decisao_confirmada", "correcao"):
        memoria_derivada.add_memory(
            fato=evento.conteudo,
            origem=evento.sessao_id,
        )
    # O resto fica só no registro bruto, disponível via search_memory
    # se algum dia for preciso reconstruir o que aconteceu, mas não
    # polui o índice de conhecimento destilado que o agente carrega
    # no início de toda sessão nova.
A separação entre “sempre grava bruto” e “só promove se parecer durável” é o que evita que a base destilada vire, com o tempo, uma cópia inchada do histórico inteiro, o mesmo problema que o desenho inteiro nasceu pra resolver.
O que isso não resolve
O ganho de 12 vezes menos token comparado a contexto completo pressupõe que a etapa de busca (search_memory, fetch_memory) encontra o fato certo na base destilada. Se a base cresce de forma desorganizada, sem a divisão e fusão de arquivo que o pipeline offline promete fazer, a economia de token pode se transformar em uma busca que não acha o que devia, trocando um problema (contexto caro) por outro (memória incompleta ou contraditória).
A pesquisa também é honesta sobre a dependência entre as duas camadas: nos testes de remoção controlada, usar só memória episódica (sem destilação) ficou em 35,8% de taxa de sucesso, usar só a derivada ficou em 66,1%, e as duas juntas em 68,4%. A camada derivada carrega a maior parte do ganho sozinha, o que levanta uma pergunta prática, se o pipeline de destilação falhar silenciosamente por algum tempo, o agente perde quase todo o benefício do mecanismo, não só uma fração dele, e isso pode não ficar óbvio até alguém notar a regressão de qualidade.
Minha ressalva: o número que mais chama atenção (taxa de sucesso triplicada versus nenhuma memória) vem de um benchmark interno, construído pela própria Databricks a partir de sessão do próprio Genie. Isso não invalida o resultado, mas significa que ele mede o mecanismo no ambiente que ele foi desenhado pra servir. Vale testar contra o próprio padrão de uso antes de assumir que o mesmo ganho se repete em um domínio bem diferente do Genie.
Vale adotar?
Sim, com uma condição: trate o pipeline de destilação como peça crítica de infraestrutura, não como detalhe de implementação que roda em segundo plano e pode ser ignorado. O ganho real do mecanismo está ali, não só em ter dois tipos de memória, e monitorar se essa etapa está realmente consolidando conhecimento (e não só acumulando arquivo) é o que separa um agente que aprende de um agente que só acumula log.
Referências
- Databricks Blog, “MemCurrent: Designing Persistent Memory for Production Agents”: https://www.databricks.com/blog/memcurrent-designing-persistent-memory-production-agents
- Databricks Blog, “Introducing Agent Memory on Databricks”: https://www.databricks.com/blog/introducing-agent-memory-databricks
- Databricks Docs (AWS), “Stateful agents, memory, and sessions”: https://docs.databricks.com/aws/en/agents/custom-agents/stateful-agents
- Microsoft Learn, “Stateful agents, memory, and sessions - Azure Databricks”: https://learn.microsoft.com/en-us/azure/databricks/agents/custom-agents/stateful-agents
#AzureDatabricks #AgentMemory #AgentBricks #MLflow