Já cobri aqui dois casos de uso de ponta do Apache Spark Real-Time Mode: uma plataforma de gaming sessionizando milhões de jogador com timer nativo, e um experimento de detecção de fraude em transação de blockchain com latência p99 abaixo de 1 milissegundo. Os dois casos provaram a tese de performance. O que faltava provar era a tese de integração: dá pra rodar isso dentro do mesmo pipeline declarativo que já cuida de batch e streaming, sem precisar manter um motor separado só pra essa parte de baixa latência?
A resposta chegou com a disponibilidade geral do Real-Time Mode integrado ao Spark Declarative Pipelines (SDP, o framework que já abriga o que antes era Delta Live Tables). Isso muda o framing: Real-Time Mode deixa de ser “uma opção avançada de Structured Streaming que você configura à parte” e vira um modo de execução que convive, no mesmo pipeline, com fluxo batch e com fluxo de streaming tradicional em micro-batch.
O mecanismo: lote longo, estágio simultâneo, shuffle em streaming
Real-Time Mode não é um micro-batch menor, é uma arquitetura de execução diferente, construída em cima de três decisões:
- Lotes de longa duração (cinco minutos por padrão): o sistema processa dado assim que ele chega na origem, dentro desse lote longo, em vez de fechar um lote curto a cada ciclo
- Agendamento simultâneo de todos os estágios: isso exige que o número de slots de tarefa disponíveis seja igual ou maior que o número de tarefas de todos os estágios daquele lote, de uma vez
- Shuffle em streaming: dado passa de um estágio pro outro assim que é produzido, sem esperar o estágio anterior terminar o lote inteiro
O intervalo de checkpoint (pipelines.trigger.interval, cinco minutos por padrão) controla a frequência com que estado e offset de origem são persistidos. Intervalo mais longo reduz overhead de checkpoint, mas aumenta o tempo de recuperação depois de uma falha e atrasa a disponibilidade de métrica. Intervalo mais curto melhora durabilidade, mas adiciona overhead.
Habilitando o recurso: três passos de configuração reais
Diferente de simplesmente ligar uma flag, habilitar Real-Time Mode num pipeline exige três passos em sequência, confirmados na documentação atual.
Primeiro, o pipeline precisa estar em modo contínuo:
{
  "continuous": true
}
Segundo, habilitar o Real-Time Mode no nível do pipeline, via configuração Spark:
spark.databricks.streaming.realTimeMode.enabled = true
Terceiro, definir um fluxo de atualização em tempo real, usando dp.create_sink() pra declarar o destino e @dp.update_flow com pipelines.trigger igual a "RealTime" apontando pra esse sink:
from pyspark import pipelines as dp

dp.create_sink("pedidos_sink", "kafka", {
    "kafka.bootstrap.servers": "<bootstrap-servers>",
    "topic": "<topico-saida>",
})

@dp.update_flow(
    name="pedidos_tempo_real",
    target="pedidos_sink",
    spark_conf={
        "pipelines.trigger": "RealTime",
        "pipelines.trigger.interval": "5 minutes",
    }
)
def pedidos_tempo_real():
    return (
        spark.readStream
            .format("kafka")
            .option("kafka.bootstrap.servers", "<bootstrap-servers>")
            .option("subscribe", "<topico-entrada>")
            .load()
    )
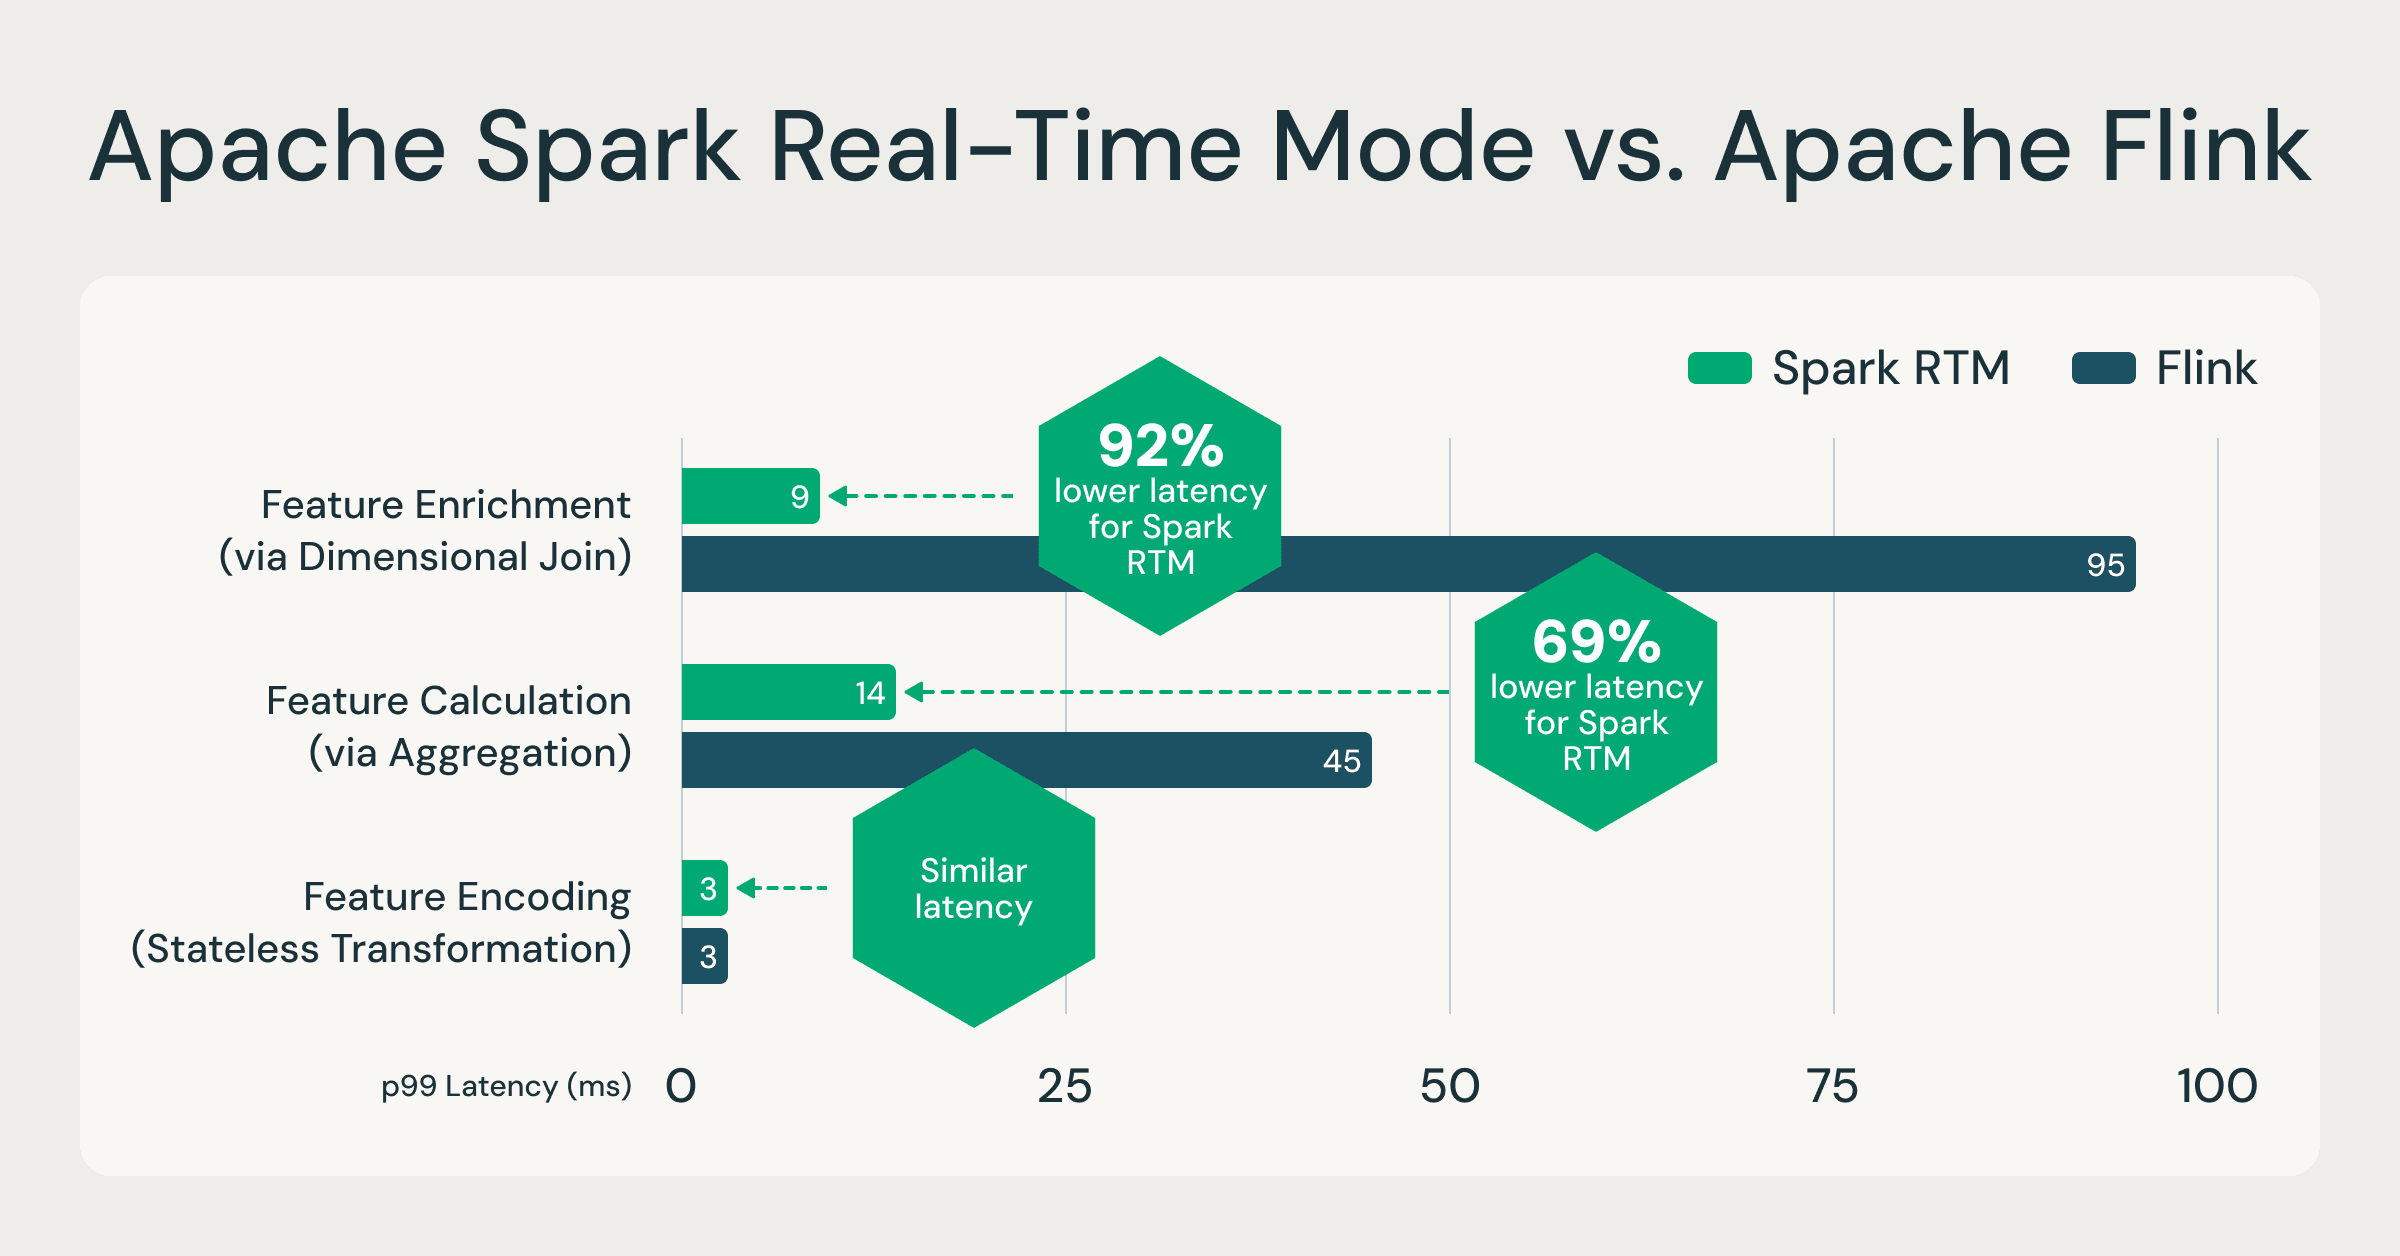
Benchmark publicado pela Databricks: ganho de até 92% em latência comparado ao Apache Flink no mesmo workload de cálculo de feature.
Sink customizado com estado: ForEach via classe writer
Pra destino sem formato de sink embutido, como chamada a API externa ou atualização de um key-value store, o mecanismo oferece o sink ForEach, que processa linha por linha. A forma mais robusta de implementar isso é via objeto writer, que abre uma conexão por partição e reaproveita ela a cada linha, em vez de abrir conexão nova pra cada registro:
from pyspark import pipelines as dp

class EscritorPedidosAPI:
    def open(self, partition_id, epoch_id):
        import requests  # import dentro do executor
        self.session = requests.Session()
        return True

    def process(self, row):
        resposta = self.session.put(
            f"https://api.empresa.com/pedidos/{row.pedido_id}",
            json={"pedido_id": row.pedido_id, "status": row.status},
            timeout=10,
        )
        resposta.raise_for_status()

    def close(self, error):
        self.session.close()

dp.foreach_sink(name="pedidos_api_sink", writer=EscritorPedidosAPI())

@dp.update_flow(
    name="pedidos_para_api",
    target="pedidos_api_sink",
    spark_conf={"pipelines.trigger": "RealTime"},
)
def pedidos_para_api():
    return spark.readStream.table("catalogo.esquema.pedidos")
O detalhe que a documentação destaca e que é fácil de ignorar: a contagem de linha gravada pelo sink ForEach não é reportada como métrica do pipeline, e o par partition_id/epoch_id só é único dentro do checkpoint de um fluxo, então se mais de um fluxo escreve no mesmo sink, ou se você roda um full refresh (que reseta o checkpoint), esses pares podem se repetir. Deduplicar com base neles exige que um único fluxo escreva naquele sink, e limpar seu próprio estado de deduplicação a cada full refresh.
Minha leitura: o detalhe que mais acho relevante aqui não é a sintaxe em si, é a decisão de design por trás dela. Forçar o sink de tempo real a ser declarado dentro da mesma estrutura de pipeline que já declara fluxo batch significa que lineage, observabilidade e controle de acesso do Unity Catalog cobrem o fluxo de baixa latência automaticamente, sem configuração paralela. É a diferença entre “mais uma feature rápida” e “a mesma governança que eu já confio, agora também rápida”.
O que é suportado, e o que ainda não é
A tabela de origem e destino suportado é mais estreita do que o nome “Real-Time Mode” sugere à primeira vista: só Apache Kafka e Azure Event Hubs (via interface compatível com Kafka) funcionam como origem e destino nativo. Delta não é suportado como origem nem como destino nesse modo, o único jeito de escrever em Delta a partir de um fluxo em tempo real é via sink ForEach customizado.
A lista de operador suportado também tem lacuna real:
- Join broadcast (stream contra tabela estática) funciona; join stream-contra-stream não é suportado
- Janela tumbling e sliding funcionam; janela de sessão não é suportada
dropDuplicatesfunciona (com estado ilimitado);dropDuplicatesWithinWatermarknão é suportadotransformWithStatefunciona, mas com diferença de comportamento:handleInputRowsé chamado uma vez por linha, não uma vez por chave por lote, e timer de tempo de evento não é suportado, só timer de tempo de processamentoflatMapGroupsWithState,mapPartitionseforEachBatchnão são suportados nesse modo
O que isso não resolve
Em computo clássico, e em pipeline serverless no canal corrente (não no canal preview), a recomendação é rodar só um fluxo em tempo real por pipeline: múltiplos fluxos competem por slot de tarefa, o que aumenta latência. Rodar múltiplos fluxos sem essa disputa de slot (via reserva automática de slot por fluxo e reparticionamento adaptativo de origem) ainda está em Beta, disponível só em pipeline serverless no canal preview.
Em computo clássico, dimensionar certo exige contar slot manualmente: um pipeline de um estágio sem estado (Kafka de origem direto pro sink) com maxPartitions igual a 8 precisa de 8 slots; um pipeline de dois estágios com shuffle de 20 partições precisa de 28; um de três estágios com dois shuffles de 20 cada precisa de 48. Errar essa conta não gera erro explícito, gera latência maior porque tarefa fica esperando slot livre.
Minha ressalva: checkpoint de Structured Streaming dentro de forEachBatch, mesmo chamando BEGIN ATOMIC pra transação multi-tabela (recurso que já cobri aqui separadamente), não avança de forma transacional. Isso significa que, mesmo com toda a integração declarativa, ainda existe uma fronteira real entre “o pipeline garante consistência dentro de uma transação” e “o checkpoint de streaming garante que você não reprocessa nem perde evento”, e as duas garantias não se fundem automaticamente só porque moram no mesmo framework agora.
Vale adotar?
Pra quem já roda Spark Declarative Pipelines e sente a dor de manter Flink separado só pra uma fatia de baixa latência do pipeline, sim, essa integração elimina a razão original de ter dois sistemas, desde que o workload caiba dentro da lista real de origem, destino e operador suportado acima, não na expectativa genérica de “Real-Time Mode faz tudo que Structured Streaming faz, só que mais rápido”. Pra quem ainda não usa SDP e só precisa de baixa latência pontual, vale pesar se a migração pro framework declarativo inteiro compensa, ou se um job de Structured Streaming avulso, sem as amarras de inicialização de pipeline, ainda resolve mais rápido.
Referências
- Databricks Blog, “Announcing General Availability of Real-Time Mode for Spark Declarative Pipelines on Databricks”: https://www.databricks.com/blog/announcing-general-availability-real-time-mode-spark-declarative-pipelines-databricks
- Microsoft Learn, “Real-time mode concepts - Azure Databricks”: https://learn.microsoft.com/en-us/azure/databricks/structured-streaming/real-time/concepts
- Microsoft Learn, “Use real-time mode in Lakeflow pipelines - Azure Databricks”: https://learn.microsoft.com/en-us/azure/databricks/ldp/real-time
- Microsoft Learn, “Use a ForEach sink to write each row in pipelines - Azure Databricks”: https://learn.microsoft.com/en-us/azure/databricks/ldp/for-each-sink
- Databricks Blog, “Introducing Real-Time Mode for Apache Spark Structured Streaming”: https://www.databricks.com/blog/introducing-real-time-mode-apache-sparktm-structured-streaming
#AzureDatabricks #StructuredStreaming #Lakeflow