Atualizar o saldo de uma conta e gravar uma linha de auditoria parecem duas operações pequenas, mas sempre foram duas operações separadas em um lakehouse: se a segunda falhasse depois que a primeira já tivesse sido confirmada, o sistema ficava num estado inconsistente que alguém precisava detectar e corrigir manualmente, ou reescrever como lógica de reconciliação customizada. Isso sempre foi domínio do warehouse transacional clássico, não do lakehouse.
Transações agora atingiram disponibilidade geral direto no Unity Catalog, cobrindo tabela gerenciada Delta Lake e Apache Iceberg. A promessa central é simples de enunciar e historicamente difícil de entregar num motor pensado pra análise em lote: múltiplas instruções, possivelmente em tabelas diferentes, confirmam juntas ou desfazem juntas, sem meio-termo.
O mecanismo: duas sintaxes, dois jeitos de commitar
O recurso vem em dois modos, pensados pra cenários diferentes, não um substituindo o outro.
O modo não interativo usa um bloco BEGIN ATOMIC ... END, pensado pra sequência fixa, job agendado, chamada via API de execução de instrução:
BEGIN ATOMIC
  UPDATE contas SET saldo = saldo - 100 WHERE id = 1;
  UPDATE contas SET saldo = saldo + 100 WHERE id = 2;
  INSERT INTO log_auditoria VALUES (1, 2, 100, current_timestamp());
END;
O modo interativo usa BEGIN TRANSACTION seguido de COMMIT (ou ROLLBACK manual), pensado pra lógica condicional, depuração, ou conexão via JDBC/ODBC/conector Python:
BEGIN TRANSACTION;
UPDATE contas SET saldo = saldo - 100 WHERE id = 1;
UPDATE contas SET saldo = saldo + 100 WHERE id = 2;
INSERT INTO log_auditoria VALUES (1, 2, 100, current_timestamp());
COMMIT;
A diferença não é só estética. O modo atômico detecta conflito em nível de linha (duas transações mexendo em linhas diferentes do mesmo arquivo de dado não entram em conflito uma com a outra), enquanto o modo interativo detecta conflito em nível de tabela, uma granularidade mais conservadora. Quem precisa de concorrência fina, muitas transações pequenas acontecendo ao mesmo tempo, ganha bem mais escolhendo o modo atômico de propósito, não só por ser o padrão mais simples de escrever.
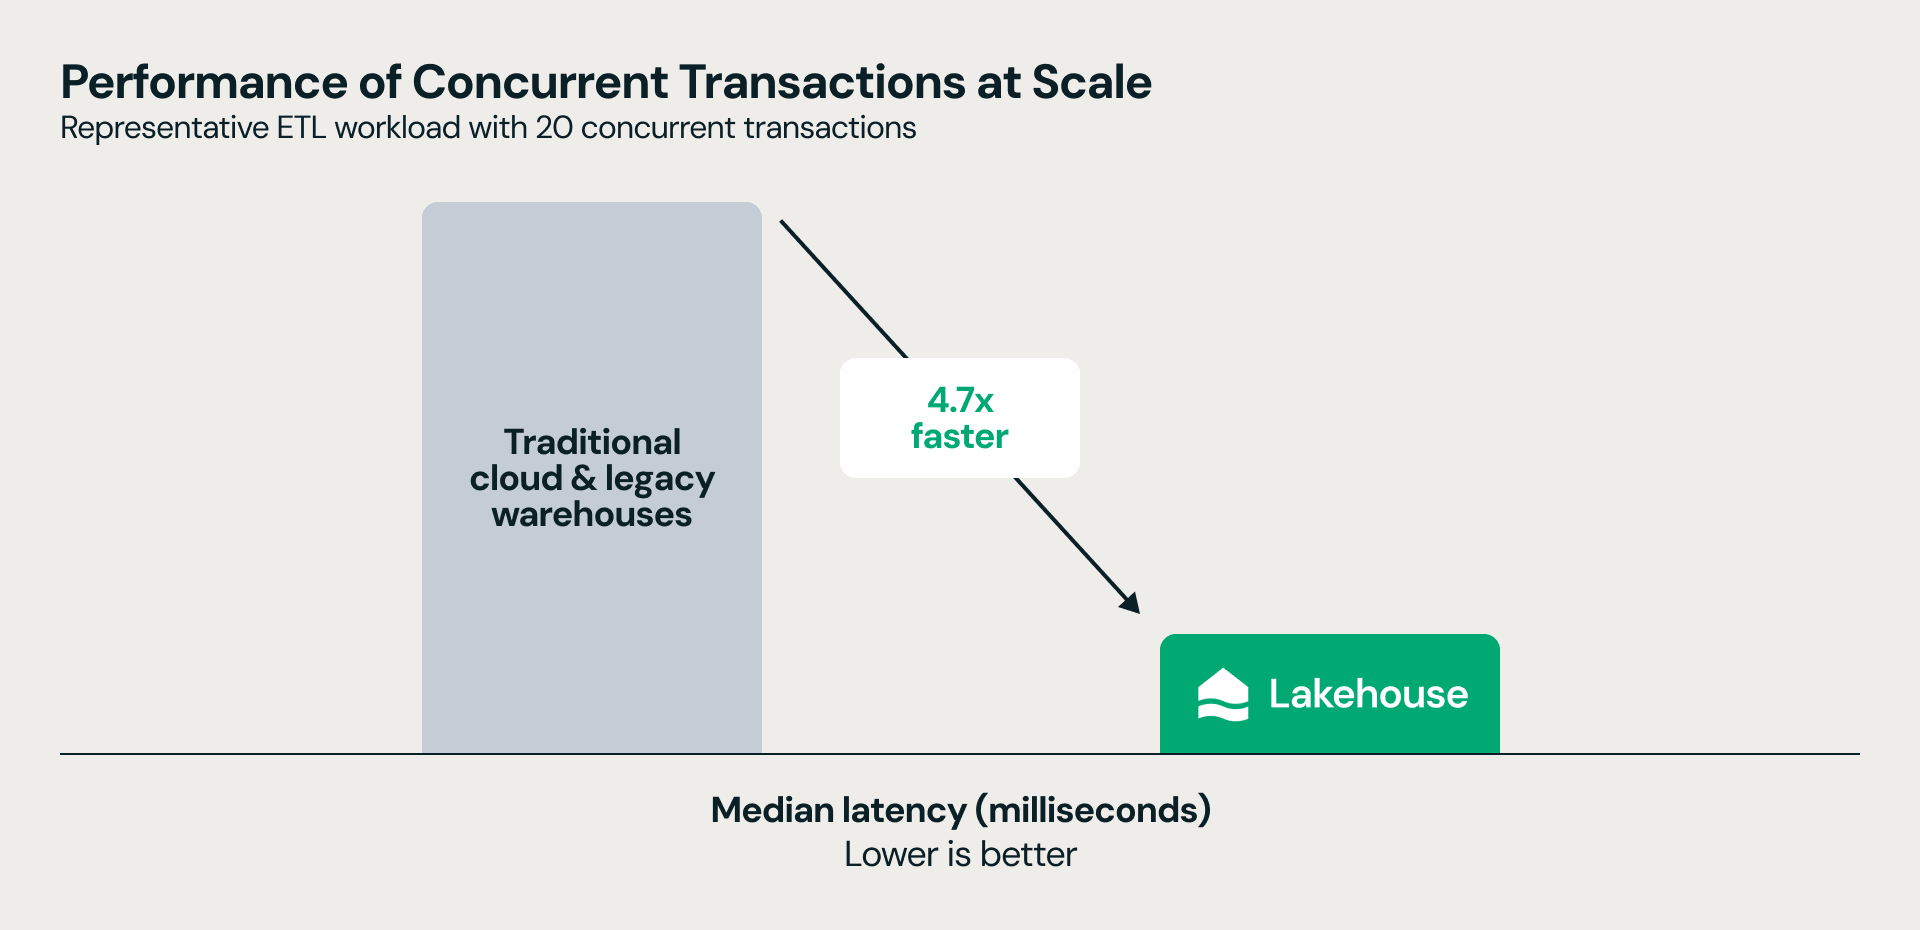
Ganho de performance reportado para transação concorrente em escala no Lakehouse, comparado ao padrão anterior de coordenar mudança entre tabelas sem suporte transacional nativo.
Concorrência otimista: nada de lock esperando sua vez
O motor não usa bloqueio pessimista (travar a linha e fazer a próxima transação esperar). Em vez disso, cada transação segue sem travar nada, e o conflito só é verificado no momento do commit: o motor checa se outra transação já modificou o mesmo dado desde que a sua começou. Se achou conflito, a transação falha e precisa ser tentada de novo com dado atualizado, em vez de ficar numa fila esperando a vez.
Isso também define o que conta como snapshot consistente: a primeira leitura de uma tabela dentro da transação captura uma fotografia daquele momento, e toda leitura seguinte da mesma tabela, dentro da mesma transação, usa essa mesma fotografia, mesmo que outra sessão mude a linha no meio do caminho.
BEGIN TRANSACTION;
SELECT * FROM produtos WHERE produto_id = 1001;
-- nesse meio tempo, outra sessão roda:
-- UPDATE produtos SET preco = 29.99 WHERE produto_id = 1001;
SELECT * FROM produtos WHERE produto_id = 1001;
-- a segunda consulta ainda retorna o preço antigo,
-- porque o snapshot foi fixado na primeira leitura
COMMIT;
Mão na massa: lendo fonte não transacional dentro da transação
Nem todo dado que uma transação precisa ler vem de tabela gerenciada. Pra ler de uma fonte externa (Parquet, CSV, JSON, tabela federada via JDBC), que não oferece a mesma garantia transacional, é preciso declarar isso explicitamente com a dica allow_nontransactional_read, justamente porque essa leitura não é repetível, mudança concorrente na fonte durante a transação pode gerar leitura inconsistente:
BEGIN TRANSACTION;

-- fonte externa, sem garantia ACID: precisa da dica explícita
INSERT INTO tabela_transacional
SELECT coluna1, coluna2
FROM tabela_externa_json
WITH (allow_nontransactional_read = true);

-- tabela gerenciada Delta: nenhuma dica necessária,
-- já tem garantia transacional nativa
INSERT INTO outra_tabela
SELECT * FROM tabela_delta_gerenciada;

COMMIT;
Essa exigência de ser explícito, em vez de deixar implícito, é uma escolha de design que vale notar: o motor força quem escreve o código a admitir, por escrito, que aquele pedaço específico da transação não tem a mesma garantia do resto.
O que isso não resolve
A lista de limitação é longa o suficiente pra merecer leitura antes de redesenhar um pipeline inteiro em cima disso. Operação DDL (CREATE TABLE, ALTER TABLE, DROP TABLE) não roda dentro de transação, precisa ficar de fora. Consulta de metadado que enumera objeto (SHOW TABLES, SHOW DATABASES) e consulta contra tabela de sistema também ficam de fora. Time travel não funciona dentro de transação. Uma transação lê ou escreve, no total, até 100 tabelas e lê até 100 views, com até 100 commits intermediários por tabela, um teto que existe mas que a maioria dos pipelines nunca vai esbarrar.
O limite mais prático de todos talvez seja o de duração: toda transação desfaz automaticamente depois de 48 horas no total, e a interativa especificamente desfaz depois de 10 minutos de inatividade. Isso empurra o desenho na direção certa (transação deve ser curta, validar cedo, falhar rápido), mas também significa que um workflow de longa duração, por natureza, nunca vai caber inteiro dentro de uma única transação, vai precisar ser quebrado em pedaços menores de qualquer forma.
Minha ressalva: concorrência otimista significa que a aplicação precisa estar preparada pra uma transação simplesmente falhar no commit e precisar ser tentada de novo, isso não é um caso de erro raro, é o comportamento esperado sob carga concorrente real. Quem porta lógica de um warehouse tradicional, acostumado a bloqueio pessimista, onde a transação só falha por erro de verdade, precisa adicionar lógica de retry explícita, ou vai ver falha intermitente que parece bug mas é, na verdade, o motor funcionando exatamente como documentado.
Vale adotar?
Pra quem já faz ETL que atualiza tabelas relacionadas como se fossem uma unidade só, hoje coordenado via lógica de reconciliação própria, ou pra quem está migrando procedure armazenada de um warehouse tradicional, sim, vale a pena, porque elimina uma categoria inteira de workaround caseiro. O padrão Write-Audit-Publish (publicar dado só depois que a checagem de qualidade passar, tudo dentro da mesma transação) também fica bem mais direto de implementar sem essa capacidade.
O que eu testaria antes de confiar isso em produção é justamente o comportamento sob conflito real: rodar duas transações concorrentes de propósito contra a mesma tabela, medir quantas falham no commit, e confirmar que a lógica de retry da aplicação realmente lida com isso, em vez de assumir que funciona só porque funcionou no teste sem concorrência.
Referências
- Microsoft Learn, “Transactions - Azure Databricks”: https://learn.microsoft.com/en-us/azure/databricks/transactions/
- Databricks Blog, “Transactions are Generally Available, advancing warehousing on the Lakehouse”: https://www.databricks.com/blog/transactions-are-generally-available-advancing-warehousing-lakehouse
- Microsoft Learn, “Catalog commits - Azure Databricks”: https://learn.microsoft.com/en-us/azure/databricks/tables/features/catalog-commits
- Microsoft Learn, “Row-level concurrency - Azure Databricks”: https://learn.microsoft.com/en-us/azure/databricks/optimizations/isolation/row-level-concurrency
#AzureDatabricks #UnityCatalog #SQL #Governanca