Reprocessar a tabela inteira só pra atualizar duas partições? Existe um padrão pra isso

O Databricks MVP Bartosz Konieczny detalha o Dynamic Data Overwriter: usar partitionOverwriteMode dinâmico ou liquid clustering com INSERT INTO…REPLACE USING pra substituir só o subconjunto de dados afetado, sem tocar no resto da tabela.
julho 2, 2026 · 2 min · 255 words · Wiliam Rosa

Testei três modelos atrás do mesmo Unity AI Gateway, e o custo de token variou cinco vezes pra pergunta idêntica

Um MVP apontou um Unity AI Gateway pra três modelos hospedados no Databricks e mediu guardrail bloqueando prompt injection 3 de 3 vezes, mas com uma diferença de até 5x no custo de token pro mesmo prompt entre modelos.

julho 2, 2026 · 2 min · 314 words · Wiliam Rosa

Delta 4.3 faz até CREATE TABLE passar pelo catálogo, não só a leitura

Delta 4.3 expande as catalog-managed tables para que operações de escrita, CREATE, REPLACE, ALTER TABLE, também passem por validação de commit do lado do catálogo, não só a leitura.

junho 23, 2026 · 2 min · 286 words · Wiliam Rosa
Databricks
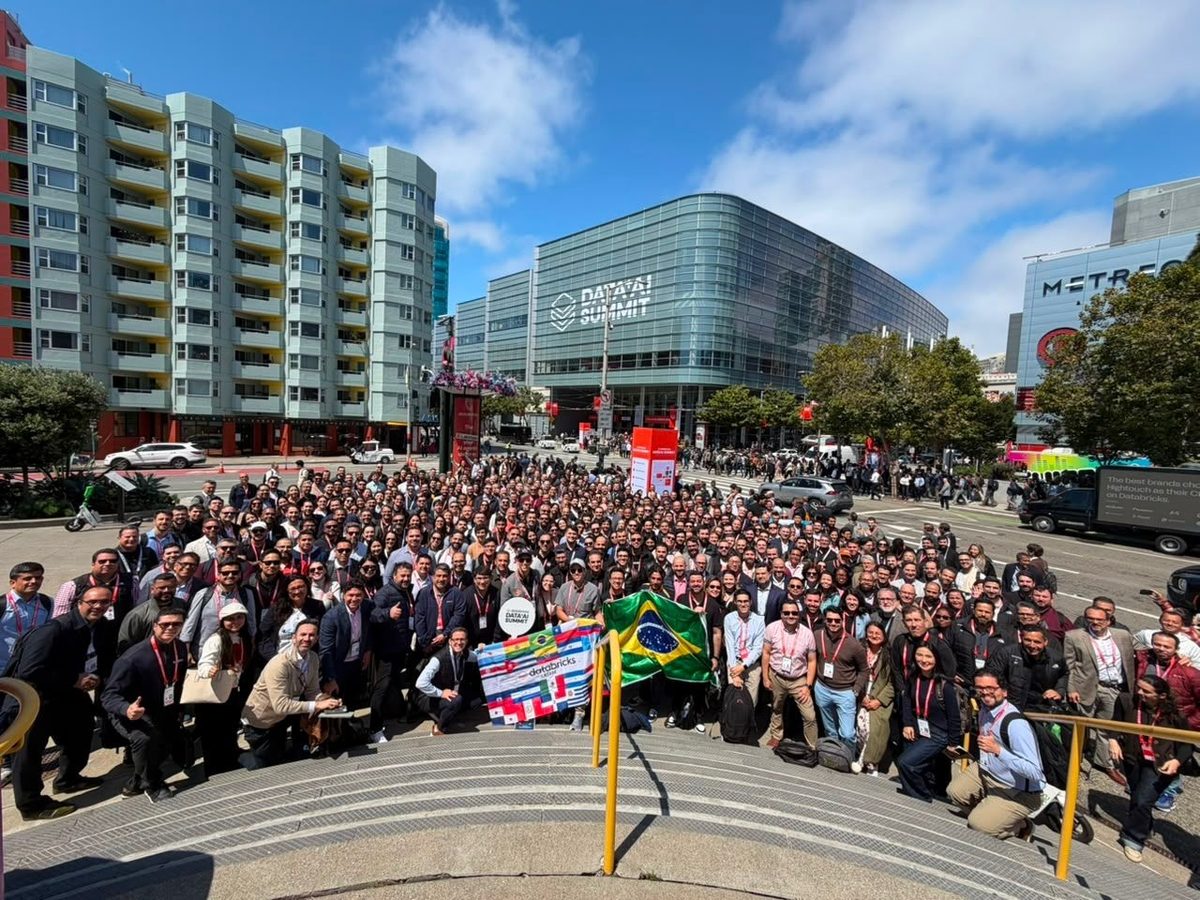
Comunidade latino-americana no Databricks Data + AI Summit 2026, em San Francisco

🌉 Databricks Data + AI Summit 2026 | San Francisco

Representei a comunidade São Paulo Databricks User Group no Data + AI Summit 2026, em San Francisco, ao lado de Nilton Kazuyuki Ueda e de centenas de pessoas da América Latina.

junho 15, 2026 · 1 min · 139 words · Wiliam Rosa

Quando o Unity Catalog vira coordenador de transação, não só o dicionário de tabelas

Catalog Commits tira a coordenação de transação do Delta Lake do object storage e coloca dentro do Unity Catalog, habilitando transação atômica entre várias tabelas e leitura de metadado sem round-trip pra nuvem. O recurso central já é GA desde maio de 2026, com Delta Spark, Flink, Trino e DuckDB entre os engines suportados, mas escrita de engine externo continua em Beta e tabela Iceberg gerenciada em Private Preview.

junho 6, 2026 · 7 min · 1328 words · Wiliam Rosa

Sessionizar milhões de jogadores sem reprocessar nada: o que muda com timer nativo no Structured Streaming

Uma plataforma de gaming usou o Apache Spark Real-Time Mode com transformWithState pra sessionizar 4 milhões de sessões simultâneas com latência p99 de 432 milissegundos, cerca de 20x mais rápido que o mesmo pipeline em micro-batch. O ganho central vem de timers nativos que produzem saída mesmo sem novo evento chegar.

junho 4, 2026 · 5 min · 1061 words · Wiliam Rosa

Lakebase ganhou CDC de graça, e o Postgres nem percebe

Lakebase Change Data Feed (ex-Lakehouse Sync) usa uma extensão de WAL do Postgres pra replicar toda escrita direto pra tabelas Delta no Unity Catalog, sem tocar na aplicação.

junho 2, 2026 · 2 min · 246 words · Wiliam Rosa

Rotear pergunta ambígua pra um modelo de reasoning não compensou, e os números provam

Um experimento comparando modelo base e modelo de reasoning em três níveis de complexidade nas Foundation Model APIs do Databricks mostrou que reasoning só compensa em tarefa de lógica multi-etapa, não em classificação ambígua.

junho 2, 2026 · 2 min · 317 words · Wiliam Rosa

5 bilhões de séries temporais, um motor só não basta: como a Databricks separou alerta rápido de investigação profunda

A própria Databricks conta como escalou monitoramento interno para 10 trilhões de amostras por dia e 5 bilhões de séries temporais ativas combinando um fork do Thanos para alerta rápido, uma camada de agregação que absorve pico de cardinalidade, e uma plataforma baseada em lakehouse para investigação profunda sobre dado bruto.

maio 6, 2026 · 7 min · 1287 words · Wiliam Rosa

Chega de copiar e colar ID do Key Vault entre Terraform e bundle, agora é só JSON

Terraform provisiona a infraestrutura, os bundles gerenciam a camada Databricks, e a integração entre os dois deixou de depender de mensagem no Slack com o ID copiado manualmente.

maio 2, 2026 · 2 min · 251 words · Wiliam Rosa